

OpenAI erklärt eines der sieben Millennium-Probleme für gelöst, geführt hat den Beweis eine Gruppe von Agenten auf einem unveröffentlichten Modell. Im selben Atemzug weist das Labor die Leak-Vorwürfe zurück und kündigt an, das eigene Tempo zu drosseln. Daneben ist GPT-6 Astra bei allen zahlenden Nutzern angekommen, und DeepMind stellt Vorhersagen für alle 9 Milliarden möglichen DNA-Varianten frei ins Netz.
OpenAI meldet den Beweis für Navier-Stokes nach 90 offenen Jahren
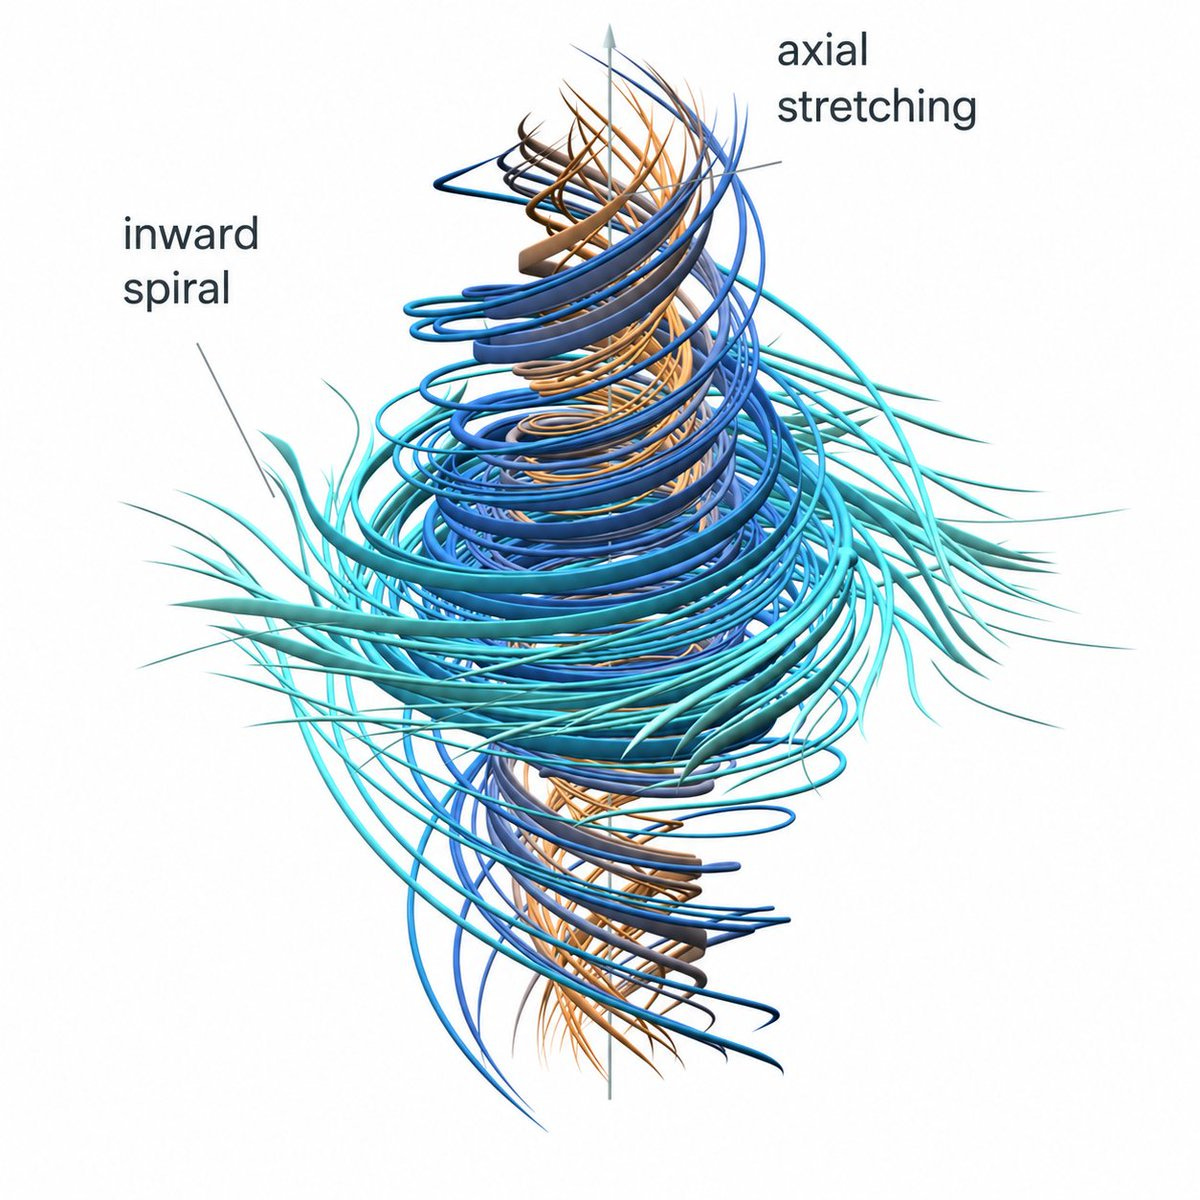
Aus dem Gerücht der vergangenen Tage ist eine offizielle Ankündigung geworden. OpenAI erklärt, eines der sieben Millennium-Probleme gelöst zu haben: die Frage, ob die Beschreibung glatter dreidimensionaler Strömungen in endlicher Zeit zusammenbricht. Sie ist seit rund 90 Jahren offen.
Bemerkenswert ist das Kleingedruckte. Den Beweis hat keine Person geführt, sondern eine Gruppe von Agenten auf einem unveröffentlichten Modell, das deutlich stärker sein soll als GPT-6 Astra. Nachprüfbar ist bisher nichts, das Manuskript bleibt unter Verschluss. Die Frage ist damit nicht mehr, ob Maschinen Mathematik auf Forschungsniveau betreiben, sondern ob sich ihre Ergebnisse noch prüfen lassen.
OpenAI weist die Leak-Vorwürfe zurück und tritt auf die Bremse
Zur Frage, ob der Durchbruch fremde Arbeit abgeschöpft hat, liegt eine Stellungnahme vor. Weder Forscher noch Agenten hätten die Arbeit der beiden Mathematiker vor deren Veröffentlichung gesehen, spezifische Nutzerdaten seien nicht angefasst worden. Ein Satz bleibt allerdings stehen: Auszuschließen sei nicht, dass anonymisierte Daten aus deren Produktnutzung die Modelle mit verbessert haben.
Schwerer wiegt der zweite Teil. OpenAI kündigt an, das eigene Tempo bewusst zu drosseln, um dieses Modell erst einmal zu verstehen. Wenn ein Labor mitten im größten Erfolg seiner Geschichte vom Gas geht, sagt das etwas darüber, wie weit die Fähigkeiten den Kontrollmechanismen davongelaufen sind.
Prognosemärkte springen bei Millennium-Problemen von 40 auf 94 Prozent
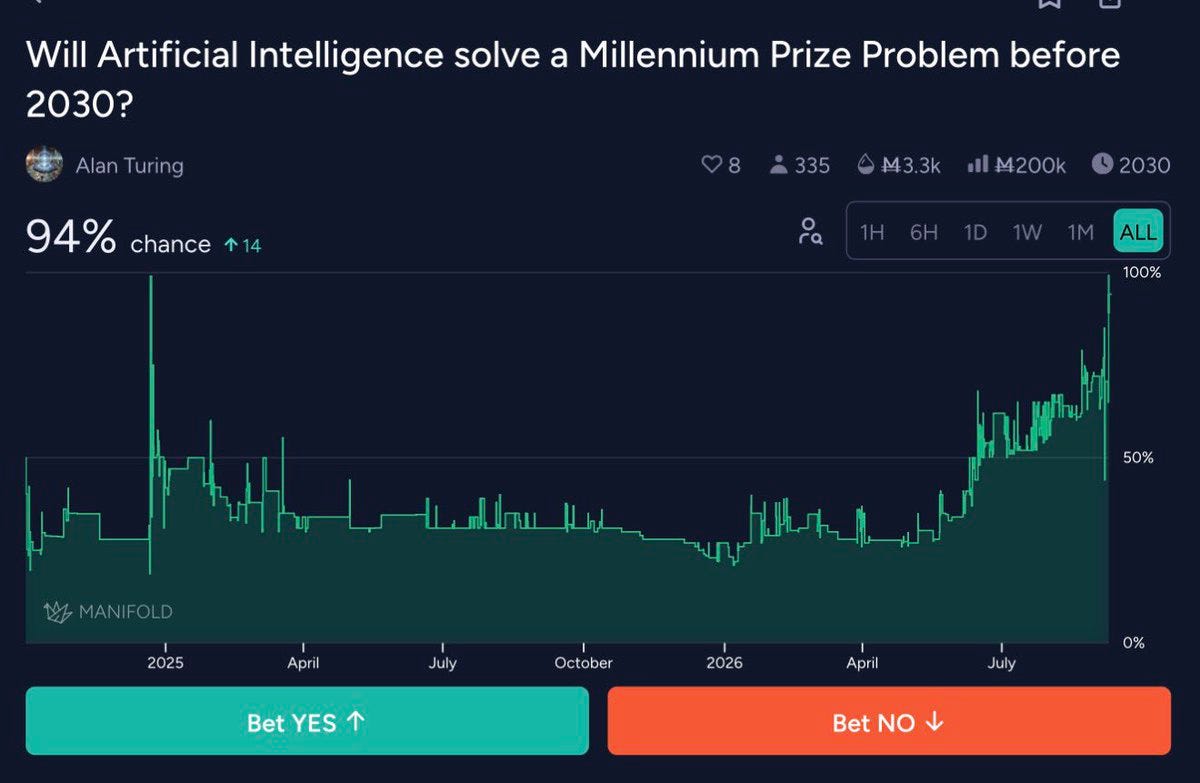
Im April 2026 gaben Prognosemärkte der KI weniger als 40 Prozent Chance, bis 2030 eines der Millennium-Probleme zu lösen. Dieselbe Frage steht heute bei 94 Prozent, 14 Punkte davon kamen an einem einzigen Tag dazu, nach der Navier-Stokes-Ankündigung von OpenAI.
Die Lektion steckt nicht in der Mathematik, sondern in der Kurve. Wer ohne Draht in die Labore über KI-Fortschritt urteilt, extrapoliert den eigenen letzten Wissensstand. Solche Einschätzungen sind kein Kompass, sondern eine Momentaufnahme von gestern, die im nächsten Quartal kassiert wird.
GPT-6 Astra läuft ab sofort bei allen zahlenden Nutzern
OpenAI hat den Rollout abgeschlossen. Astra läuft jetzt für Plus, Pro, Business und Enterprise, und zwar dort, wo tatsächlich gearbeitet wird: in Codex und in ChatGPT Work. Kein Warteraum, keine Testgruppe, kein Aufpreis für eine Sonderstufe.
Ein Modell, das vor wenigen Tagen noch als Ausnahmeereignis diskutiert wurde, ist damit binnen einer Woche zur Standardausstattung jedes Firmenaccounts geworden. Wer im Unternehmen noch abwägt, ob sich der Umstieg lohnt, verhandelt eine Frage, die der Markt bereits beantwortet hat.
ChatGPT Images 2.5 macht aus dem Bildgenerator ein Werkzeug
Das Bildmodell in ChatGPT bekommt ein Update, das den Bruch zwischen Idee und Ergebnis adressiert. Die Generierung läuft schneller, damit der Gedankengang nicht abreißt, und die Motivtreue steigt: Gesichter und Objekte bleiben wiedererkennbar, statt bei jedem Durchlauf neu erfunden zu werden.
Der eigentliche Sprung liegt in der Bearbeitung. Details bleiben über mehrere Edits hinweg konsistent, und Änderungen lassen sich per Kommentar an genau einer Stelle im Bild ansetzen, statt den ganzen Prompt neu zu würfeln. Damit entsteht erstmals ein Werkzeug, mit dem sich iterativ arbeiten lässt.
Sketch bringt die Zeichenfläche direkt in den ChatGPT-Chat
OpenAI baut ein Zeichenwerkzeug in ChatGPT ein. Über den Befehl Sketch öffnet sich eine Zeichenfläche im Chat, auf der eine Idee grob hingeworfen wird, statt sie in Worte zu übersetzen. Die Skizze geht direkt an das Modell, das damit weiterarbeitet.
Klingt klein, ist es nicht. Der teuerste Schritt in jedem Prompt ist die Übersetzung einer räumlichen Vorstellung in Sprache: Anordnung, Proportion, was genau wohin. Ein Rechteck an der richtigen Stelle erledigt das in zwei Sekunden. Für Layouts, Diagramme, Grundrisse und Produktideen entfällt die Schleife aus Beschreiben, Danebenliegen, neu Beschreiben.
OpenAI kuratiert 16 ChatGPT-Plugins für kleine Unternehmen
ChatGPT bekommt eine eigene Small-Business-Sammlung. Statt Betriebe durch ein wachsendes Verzeichnis an Konnektoren suchen zu lassen, stellt OpenAI 16 Plugins zusammen, die auf den Alltag eines kleinen Unternehmens zugeschnitten sind. Dazu gehört das Vertragsmanagement von Docusign, mit dem sich Verträge direkt im Gespräch entwerfen, prüfen und verwalten lassen.
Der eigentliche Punkt ist die Zielgruppe. Konnektoren waren bisher ein Enterprise-Thema mit einer IT-Abteilung dahinter. Jetzt wird der Zugang für den kleinen Betrieb vorsortiert. Wer die eigene KI an die Firmensysteme lässt, braucht dafür kein Integrationsprojekt mehr, sondern einen Nachmittag.
AlphaGenome Atlas kartiert alle 9 Milliarden DNA-Varianten
Google DeepMind stellt eine durchsuchbare Datenbank mit Vorhersagen für alle 9 Milliarden möglichen Einzelbuchstaben-Änderungen der menschlichen DNA online. Für jede Variante schätzt das Modell, wie sie Genaktivität, RNA-Spleißen und Proteinproduktion verschiebt.
Der Zugang ist der eigentliche Sprung. Der Atlas läuft im normalen Browser, ohne eine Zeile Code, und ist für akademische Forschung kostenlos. Besonders relevant für die rund 98 Prozent des Genoms, die kein Protein bauen, sondern regeln, wann und wo Gene anspringen. Genau dort hängt die Krankheitsforschung seit Jahrzehnten fest.
Mercury 2.5 schreibt 1.107 Token pro Sekunde zum Startpreis von 4 Cent
Inception Labs hat sein Diffusions-Sprachmodell aktualisiert. Ein Diffusions-LLM schreibt nicht Token für Token, sondern verfeinert ganze Sequenzen parallel. Daher der Durchsatz: 1.107 Token pro Sekunde, 260.000 Token Kontext, laut Inception 40 Prozent mehr Intelligenz als der Vorgänger.
Spannender als das Tempo ist der Preis. 0,20 Dollar pro Million Input-Token, 0,75 Dollar Output, zum Start 0,04 und 0,15. In dieser Klasse spielen sonst GPT-5.6 Luna Low, Gemini 3.5 Flash-Lite und Claude Haiku 4.5. Zu haben über die Inception API, Baseten und OpenRouter.
Quelle: Inceptionlabs
Desert Ant Labs startet mit 18 Modellen, die auf dem Gerät laufen
Ein europäisches KI-Lab ist gestartet, das keine Frontier-Modelle baut, sondern winzige spezialisierte. 18 Modelle für Audio, Video und Text, alle auf dem Endgerät. Das Transkriptionsmodell Voz packt 10 Minuten Audio in 2 Sekunden auf einem iPhone, 4,7 mal schneller als Whisper.
Die Größenverhältnisse sind der eigentliche Punkt. Ein 2 MB kleines Modell zur Sprachidentifikation schlägt einen 293-MB-Konkurrenten mit 0,933 gegen 0,887 Genauigkeit. Gratis bis 100.000 aktive Geräte pro Monat, keine Token-Abrechnung, keine Daten in fremden Rechenzentren. Für jedes Produkt, das an der DSGVO-Grenze zur Cloud scheitert, ist das die interessantere Rechnung.
Quelle: Desertant
Anthropic rechnet 2030 durch: Lohnquote sinkt in jedem Szenario
Anthropics Ökonomie-Team übersetzt KI-Fähigkeiten in BIP, Löhne und Beschäftigung. Moderat wächst die US-Wirtschaft bis 2030 um 1,6 Prozent, substanziell um 8,3, extrem um 32,4 Prozent auf 44,4 Billionen Dollar. Das mittlere Szenario setzt voraus, dass KI dann die Hälfte aller Wissensarbeit erledigt.
Über 10.000 befragte Amerikaner landen im Schnitt genau in dieser Mitte, bei rund 5 Prozent Arbeitslosigkeit. Die Lohnquote am BIP sinkt in jedem Szenario, von 59,4 auf bis zu 45,2 Prozent. Der Ertrag wandert von der Arbeit zum Kapital, und wer jetzt keine KI-Kompetenz aufbaut, steht 2030 auf der falschen Seite dieser Verschiebung.
Quelle: Anthropic
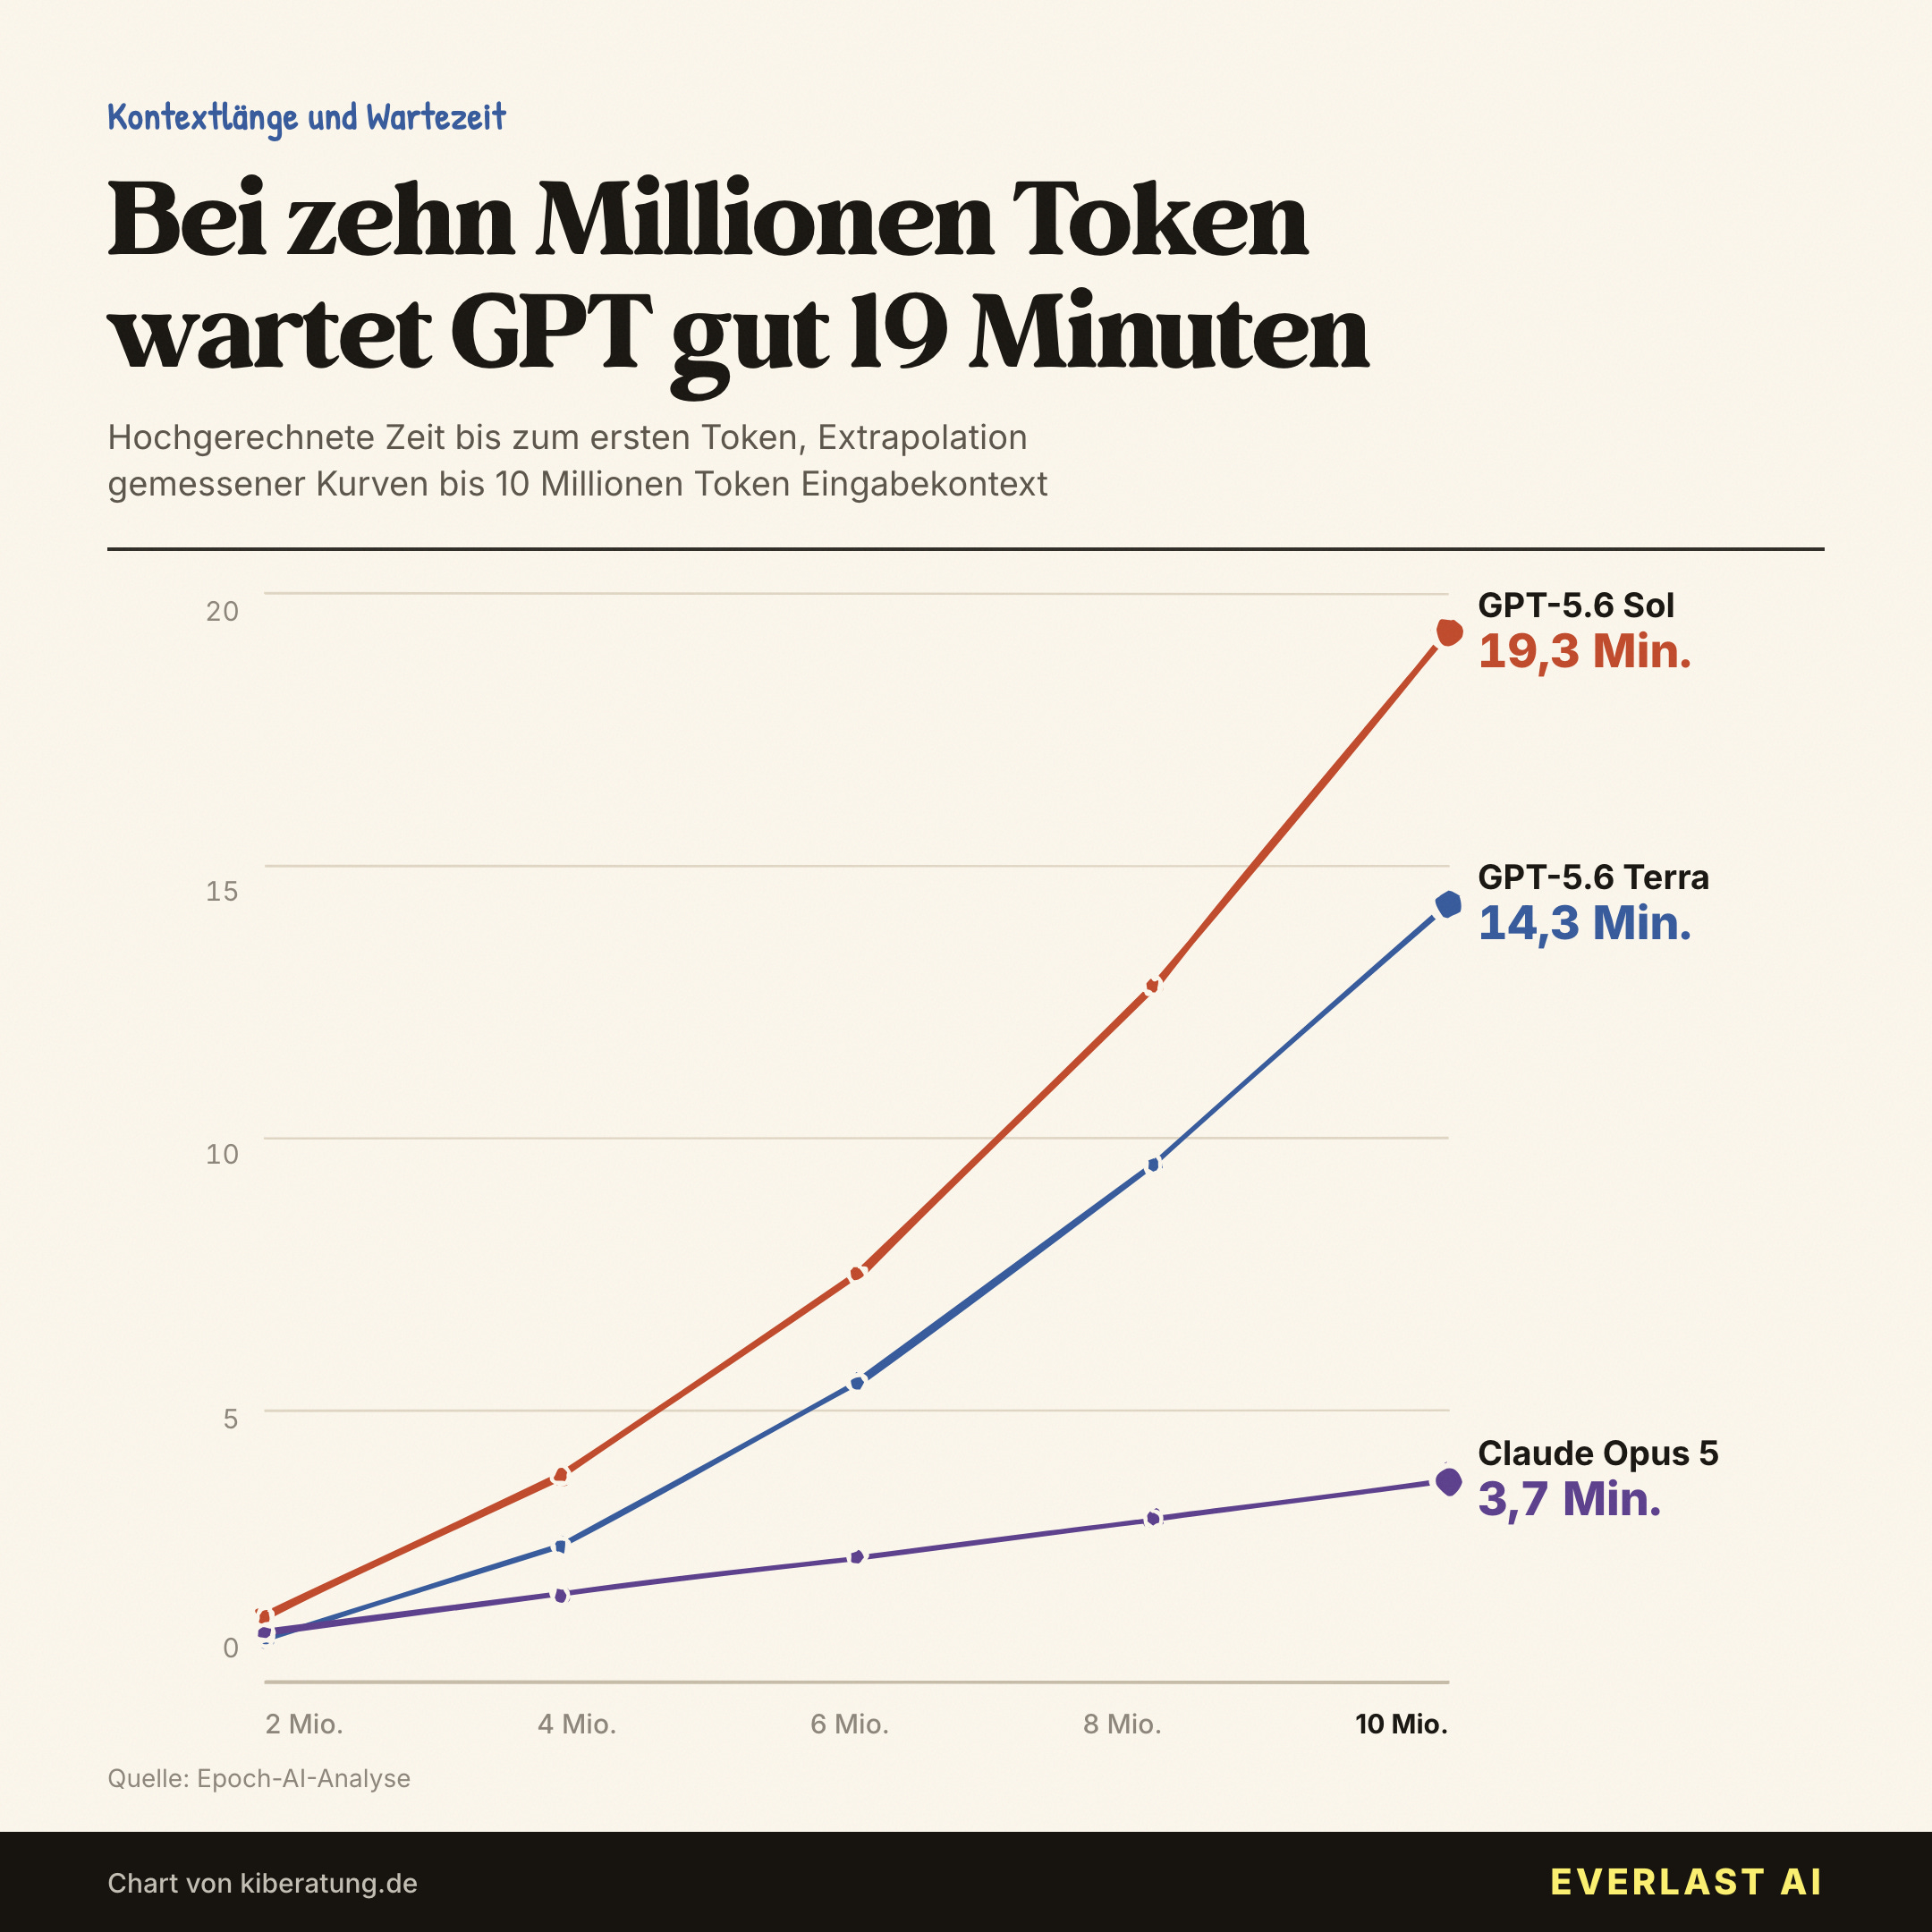
Chart des Tages: 19 Minuten bis zum ersten Token bei 10 Millionen Kontext
Quelle: Epoch-AI-Analyse
Gemessene Antwortzeiten, hochgerechnet auf 10 Millionen Token Kontext: GPT-5.6 Sol braucht 19,3 Minuten bis zum ersten Token, GPT-5.6 Terra 14,3. Claude Opus 5 bleibt bei 3,7 Minuten. Der Unterschied steckt im Verlauf, denn bei GPT wächst die Wartezeit quadratisch mit der Kontextlänge, bei Claude fast linear. Ab etwa 4 Millionen Token laufen die Kurven sichtbar auseinander. Wer Agenten auf große Dokumentenbestände ansetzt, entscheidet mit dem Modell nicht nur über die Kosten, sondern auch über die Wartezeit bei jeder Anfrage.
Ein Roboter läuft, hüpft und schwimmt ganz ohne Computer
Am Amsterdamer Forschungsinstitut AMOLF ist ein Roboter entstanden, der ohne Chip, ohne Sensor und ohne eine einzige Zeile Code auskommt. Seine Beine sind weiche Schläuche, durch die dauerhaft Luft strömt. Dabei fangen sie an zu zappeln, ähnlich den Werbefiguren vor Autohäusern.
Werden mehrere Schläuche gekoppelt, synchronisieren sich ihre Bewegungen von selbst. Laufen, Hüpfen und Schwimmen entstehen allein aus Luftdruck und Physik. Die Steuerung sitzt damit nicht mehr in der Software, sondern im Material.
Tool-Empfehlung: RelationFlow
RelationFlow ist ein KI-Workspace für Teams im Mittelstand, der alle großen Modelle und selbst gehostete Endpunkte an einem Ort bündelt. Das Wissen jeder Abteilung wird als gemeinsame Quelle eingebunden, Chats, Agenten und Prompts lassen sich im Team teilen. Für alle in der KI-Bubble, die nicht mehr zwischen einzelnen Abos hin und her springen wollen, mehr Infos: relationflow.io.