

Mistral holt drei Milliarden Euro und damit die größte Eigenkapitalrunde der europäischen Tech-Geschichte. Parallel schiebt GPT-6 Astra die autonome Aufgabenlänge auf 16 Stunden und trifft damit exakt eine Prognose vom Dezember 2025. Dazu dreht OpenAI erstmals seit einem Jahr den Traffic-Trend gegen Gemini.
Mistral sammelt 3 Milliarden Euro, Europas größte Eigenkapitalrunde
Drei Jahre nach der Gründung holt Mistral eine Series D über 3 Milliarden Euro, die größte Eigenkapitalrunde, die ein europäisches Tech-Unternehmen je gestemmt hat. Angeführt wird sie von Samsung, co-geleitet von EQTs Scaleup Europe Fund und PSG Equity, mit ASML, NVIDIA und BNP Paribas CIB weiter an Bord. Das Kapital geht in Infrastruktur, Produktreife und Deployment im großen Maßstab, vor allem aber in eigene Frontier-Modelle. Für Entscheider im DACH-Raum verschiebt das eine Rechnung: Wer Datenhoheit und EU-Hosting als harte Anforderung hat, musste sich bisher zwischen Compliance und Modellqualität entscheiden. Diese Lücke wird gerade mit drei Milliarden zugeschüttet.
GPT-6 Astra hält 16 Stunden autonome Aufgabenlänge durch
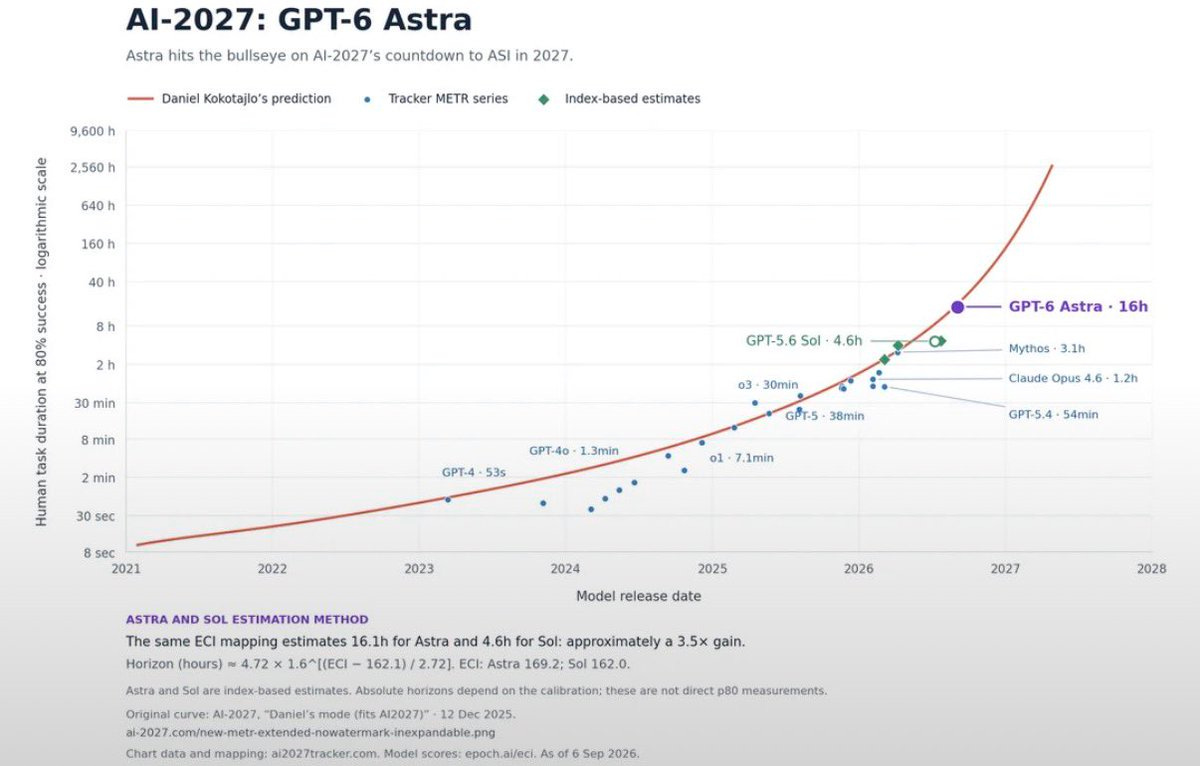
METR misst nicht Benchmarks, sondern Zeit: Wie lange darf eine Aufgabe dauern, die ein Modell noch mit 80 Prozent Trefferquote löst? GPT-4 schaffte 2023 noch 53 Sekunden, o1 kam auf 7 Minuten, GPT-5 auf 38, Claude Opus 4.6 auf 1,2 Stunden. GPT-6 Astra steht jetzt bei 16 Stunden, dem 3,5-fachen von GPT-5.6 Sol mit 4,6 Stunden. Der eigentliche Punkt liegt in der Linie darunter: Die AI-2027-Prognose vom Dezember 2025 hatte genau diesen Wert vorhergesagt, und Astra trifft ihn exakt. Fortgeschrieben verlangt dieselbe Kurve bis Dezember rund 160 Stunden, also einen Arbeitsmonat am Stück ohne Aufsicht. Die Skala ist logarithmisch.
Gemini 3.8 Flash und Muse Spark brechen auf Terminal Bench 4.0 ein
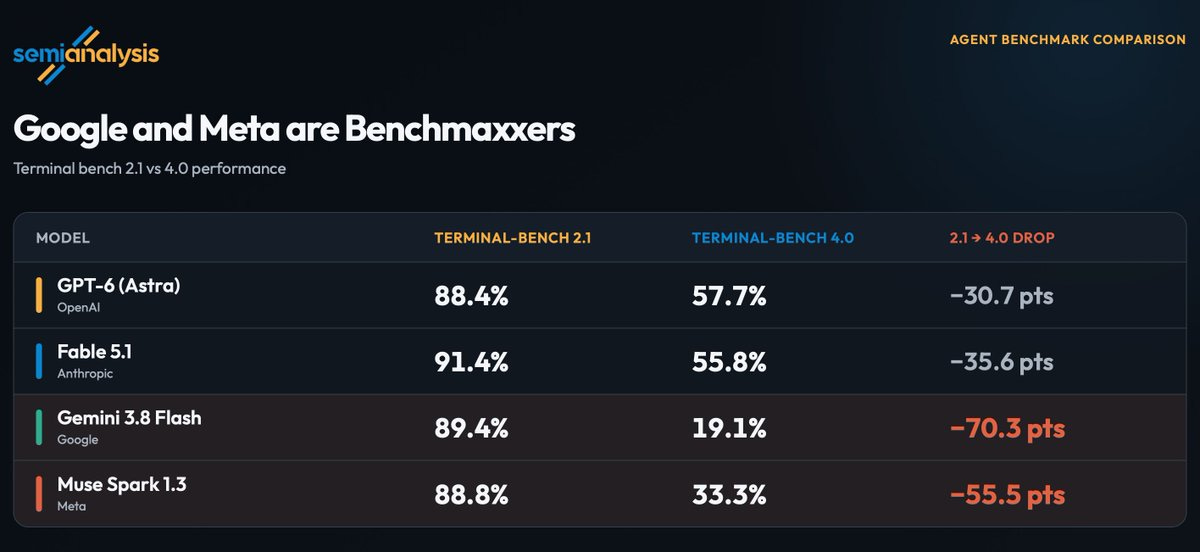
Gemini 3.8 Flash und Muse Spark 1.3 liegen auf Terminal Bench 2.1 gleichauf mit GPT-6 und Fable 5.1. Auf dem neueren Terminal Bench 4.0 brechen beide deutlich ein. Für das Muster gibt es einen Namen: benchmaxxed, optimiert auf die Prüfung statt auf die Aufgabe. Das heißt nicht, dass die Modelle schwach wären, die Spitze zieht weiter davon. Es heißt, dass Leaderboards als Einkaufskriterium verschleißen, sobald ein Benchmark alt genug ist, um im Training zu landen. Wer ein Modell auswählt, testet es an den eigenen Prozessen und mit eigenen Daten.
DeepSeek schiebt v4.1 Flash still in die API
Kein Launch-Event, keine Keynote. Das Modell liegt unter der ID deepseek-v4.1-flash-expires-on-0910 im laufenden Betrieb, gleiche base_url, gleicher Preis wie v4 Flash, 20 parallele Anfragen pro Account. Am 10. September läuft die Beta wieder ab. Neu ist die Architektur: nativ multimodal, deutlich schneller, erste Messungen liegen bei 400 bis 500 Tokens pro Sekunde. DeepSeek testet vor Publikum statt hinter verschlossenen Türen und lässt die Nutzer den Benchmark schreiben. Wer Agenten baut, rechnet die Kostenseite noch diese Woche gegen die eigene Pipeline.
Quelle: Api-docs
OpenAI dreht den Traffic-Trend erstmals seit zwölf Monaten
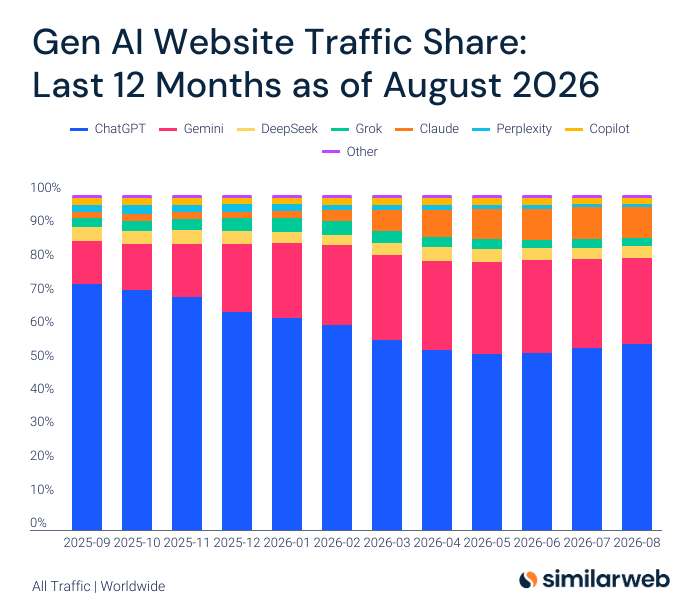
Der Anteil von ChatGPT am Gen-KI-Web-Traffic fiel binnen zwölf Monaten von 73,3 auf 56,7 Prozent, Gemini schoss im selben Zeitraum von 12,9 auf 25,4 Prozent hoch. Seit rund zwei Monaten läuft die Bewegung rückwärts: OpenAI klettert von etwa 52 auf 54 Prozent, überwiegend zulasten von Gemini. Der Zeitpunkt fällt exakt mit dem exponentiellen Wachstum von Codex und ChatGPT Work zusammen. Nicht der Chatbot holt den Anteil zurück, sondern die Arbeitsschicht darüber: Agenten, die Code schreiben und Büroarbeit erledigen. Marktanteil entsteht ab jetzt dort, wo Modelle Aufgaben abschließen, nicht dort, wo sie antworten.
OpenAI beansprucht Navier-Stokes, Mathematiker erhebt Leak-Vorwürfe
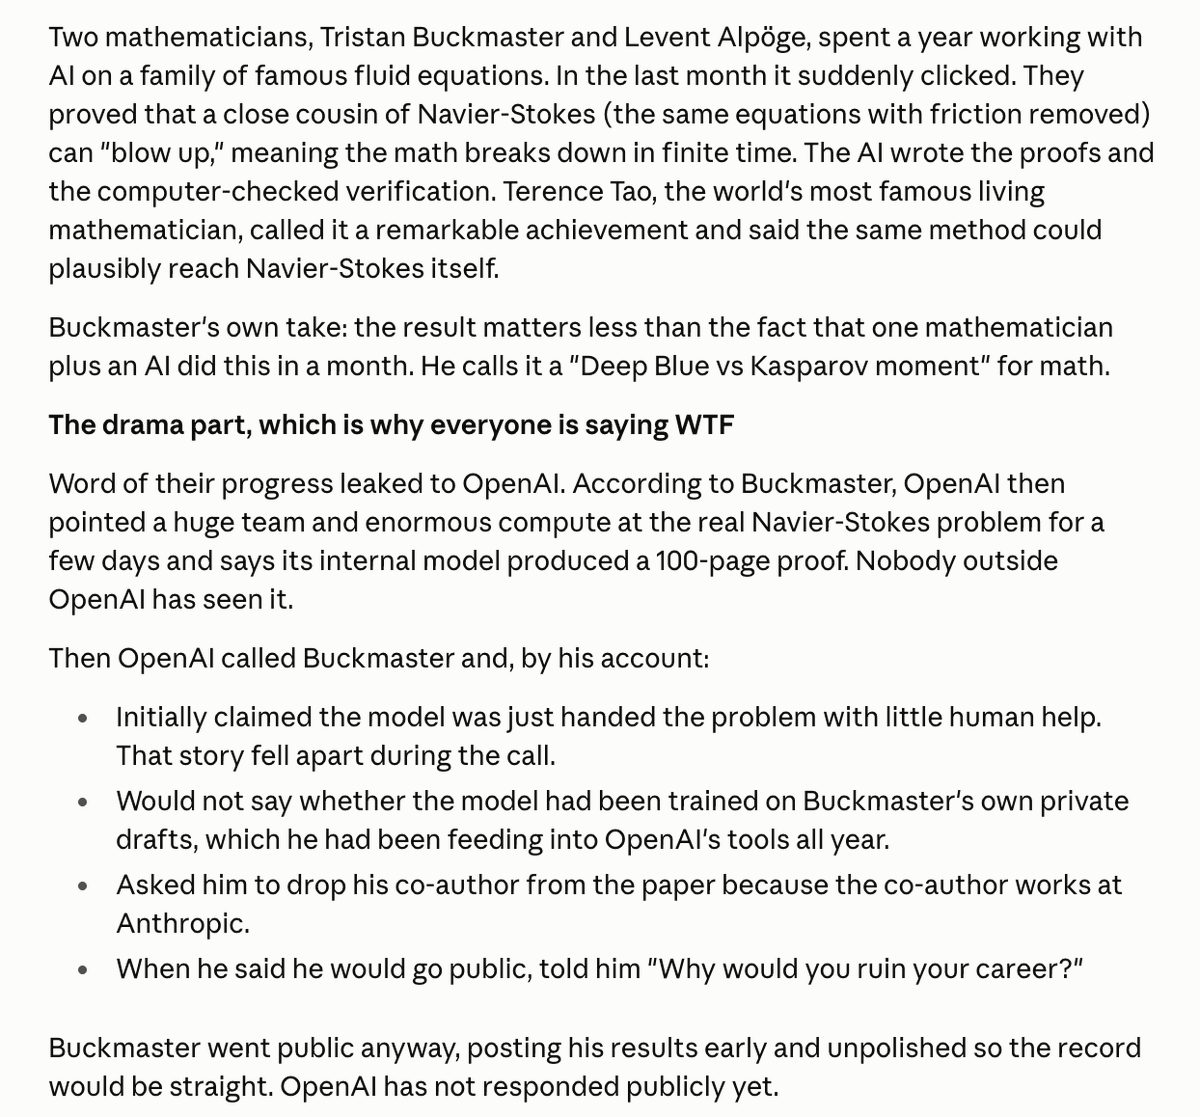
Navier-Stokes ist eines der sieben Millennium-Probleme, eine Million Dollar Preisgeld, in der Bekanntheit nur von der Riemann-Hypothese und P vs NP übertroffen. Belegt ist bisher allerdings nur die Lösung des direkten Nachbarproblems, erarbeitet von einem Mathematiker, der ein Jahr lang mit KI daran gesessen hat. Der wirft OpenAI vor, nach einem Leak seiner Arbeit auf die Ziellinie gesprintet zu sein und ihn gedrängt zu haben, seinen Koautor fallenzulassen, weil dieser bei Anthropic arbeitet. Ein Beweis für das eigentliche Problem liegt bis heute nicht öffentlich vor, eine Stellungnahme ebenso wenig. Die offene Frage ist längst nicht mehr, ob Maschinen Mathematik auf Forschungsniveau betreiben, sondern wem so ein Durchbruch am Ende zugerechnet wird.
Metas Muse-Agent geht in die geschlossene Alpha
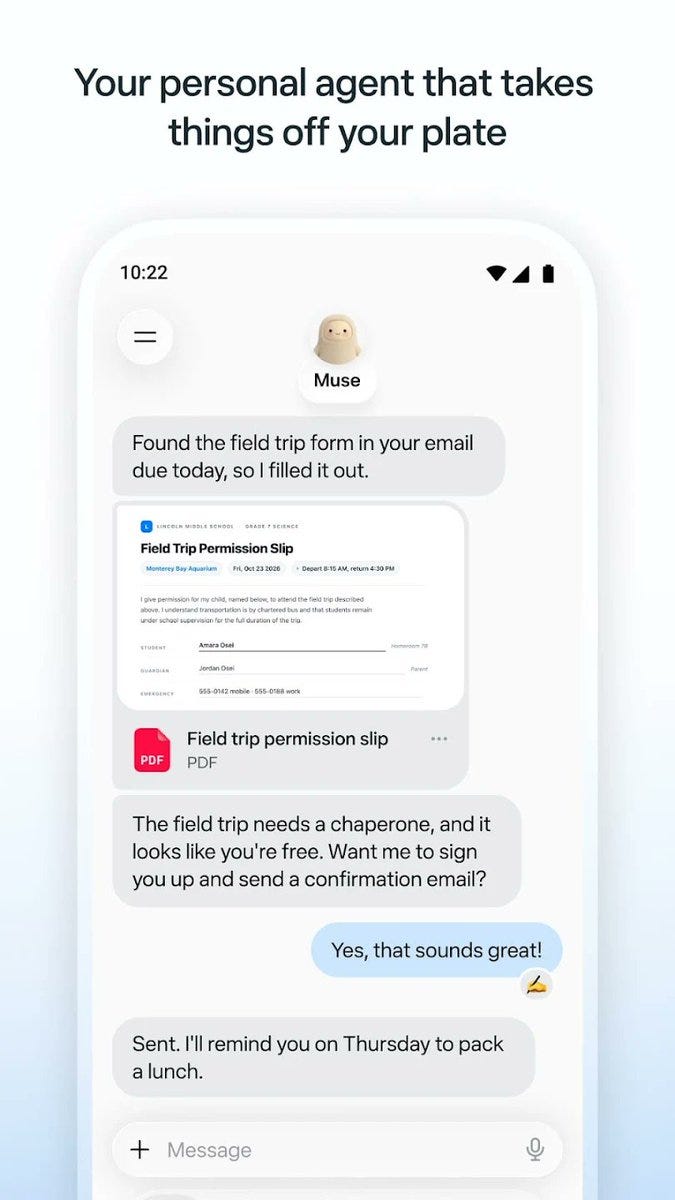
Im App-Store-Eintrag von Meta ist ein Assistent aufgetaucht, der nicht auf Prompts wartet: Muse soll Ziele mitverfolgen, Termine und Aufgaben im Blick behalten und von sich aus nachfassen. Der Agent hat den Sprung vom internen Test in die geschlossene Alpha geschafft, dazu kam frisch ein System für Einladungscodes. Assistenz heißt bisher ein Fenster, in das man tippt. Die nächste Stufe meldet sich ungefragt, weil sie den Kontext ohnehin hat. Rollt Meta das über Milliarden Geräte aus, verschiebt sich die Erwartung an jede interne Software.
ChatGPT Work lernt den persönlichen Schreibstil aus Gmail und Slack
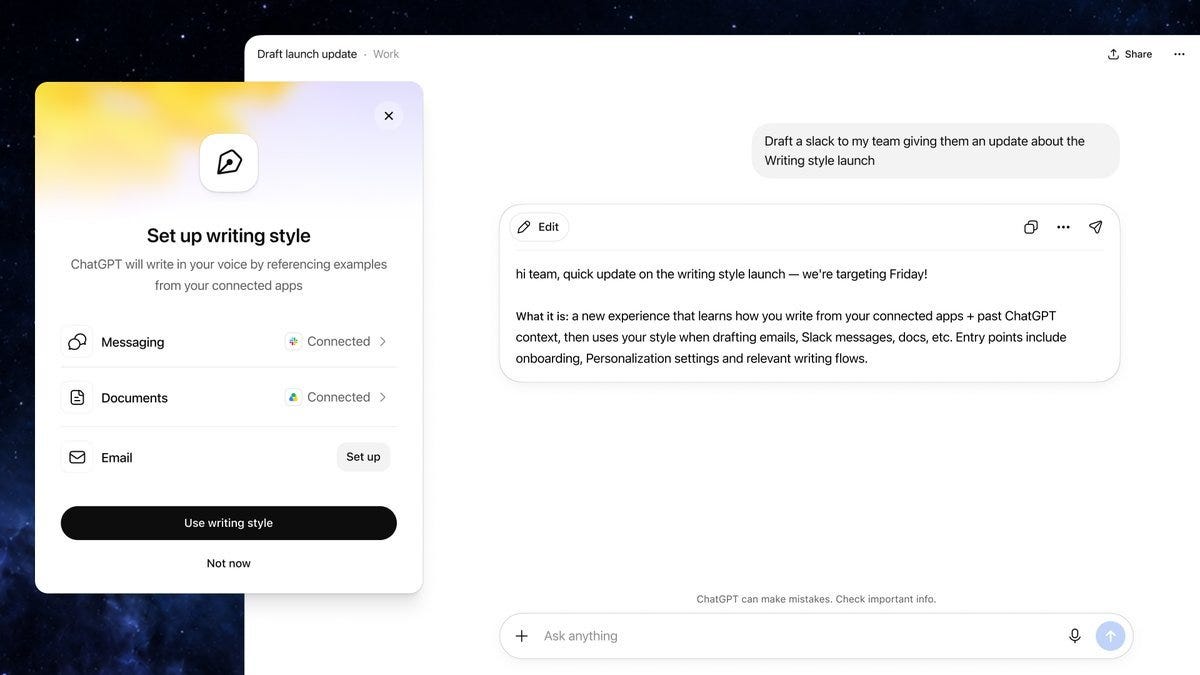
OpenAI hat ChatGPT Work beigebracht, den persönlichen Schreibstil aus verbundenen Quellen zu lernen. Angebunden werden Gmail, Google Drive, Slack und SharePoint, ausgewertet werden Lieblingsformulierungen, Grußformeln und sogar Eigenheiten bei der Groß- und Kleinschreibung. Die landen dann in künftigen Entwürfen. Damit bekommt automatisierte Arbeit eine menschliche Handschrift, die am anderen Ende oft ohnehin von einem Agenten gelesen und beantwortet wird. Handfest ist es trotzdem: Der Ton eines Unternehmens wird zur konfigurierbaren Größe statt zur Frage, wer gerade tippt.
Gemini Desktop testet eine kanonische Projects-Ansicht
In der Desktop-App taucht eine kanonische Projects-Ansicht im Test auf, technisch nah an der Variante aus Gemini Business. Dateien, Kontext und Chats bündeln sich pro Projekt, statt in losen Threads zu verpuffen. Getestet wird das parallel zur NotebookLM-Integration, ersetzen soll es sie nicht. Nach eigenen MCP-Servern in Gemini Business ist das der zweite Schritt in dieselbe Richtung: Google baut die Oberfläche vom Chatfenster zum Arbeitsraum um.
AMD steigert den vLLM-Durchsatz auf der MI355X um das 11-fache
AMD hat den vLLM-Durchsatz auf der MI355X bei agentischen Workloads mit dem MiniMax-M3-Modell um den Faktor 11 gehoben, in unter 19 Tagen und ausschließlich über Software. Der Hebel lag vor allem im Kernel für Long-Context-Attention, dazu kamen weitere Optimierungen im ROCm-Stack. Für Entscheider ist das die eigentliche Meldung: Eingekaufte Rechenleistung ist kein fixer Wert mehr, sondern eine Kurve, die nach oben läuft. Hardware einmal beschaffen, Performance über Jahre kostenlos nachgeliefert bekommen. Der Abstand zwischen den Beschleuniger-Ökosystemen entscheidet sich damit immer weniger im Silizium und immer mehr im Compiler.
Shannon 3.0 findet die SQL-Injection für 115 statt 4.000 Dollar
Keygraph hat sein neues Modell Shannon 3.0 gegen Photoview 2.4.0 laufen lassen, denselben Build, an dem zuvor die kommerziellen Scanner Aikido und XBOW gemessen wurden. Alle drei getesteten Modell-Konfigurationen fanden die kritische SQL-Injection noch vor der Authentifizierung. Die Rechnung: DeepSeek v4 Flash 6,10 Dollar an Tokens, Grok 4.6 35,07 Dollar, Opus 5 115 Dollar bei sechs von sieben behobenen Lücken. Die kommerziellen Plattformen kosten 4.000 Dollar pro Scan.
XPeng lässt Roboter Humanoide am Fließband bauen
In Guangzhou läuft ab sofort die erste automatisierte Fertigungslinie für universelle Humanoide. Roboter bauen dort Roboter, weitgehend autonom. Der erste IRON hat die Montage durchlaufen und ist am Ende selbst vom Band gelaufen. Damit verschiebt sich die entscheidende Frage: Sie lautet nicht mehr, ob ein Humanoid laufen und greifen kann, sondern zu welchen Stückkosten er sich reproduzieren lässt. Genau an dieser Stelle ist bisher jede Robotik-Vision gescheitert, an der Manufaktur. Wer die Fertigung selbst automatisiert, bricht die Skalierungsgrenze auf und macht aus dem Prototyp ein Produkt. Für Industrie und Logistik im DACH-Raum heißt das, die Verfügbarkeit kommt schneller als die meisten Planungen dafür vorgesehen haben.
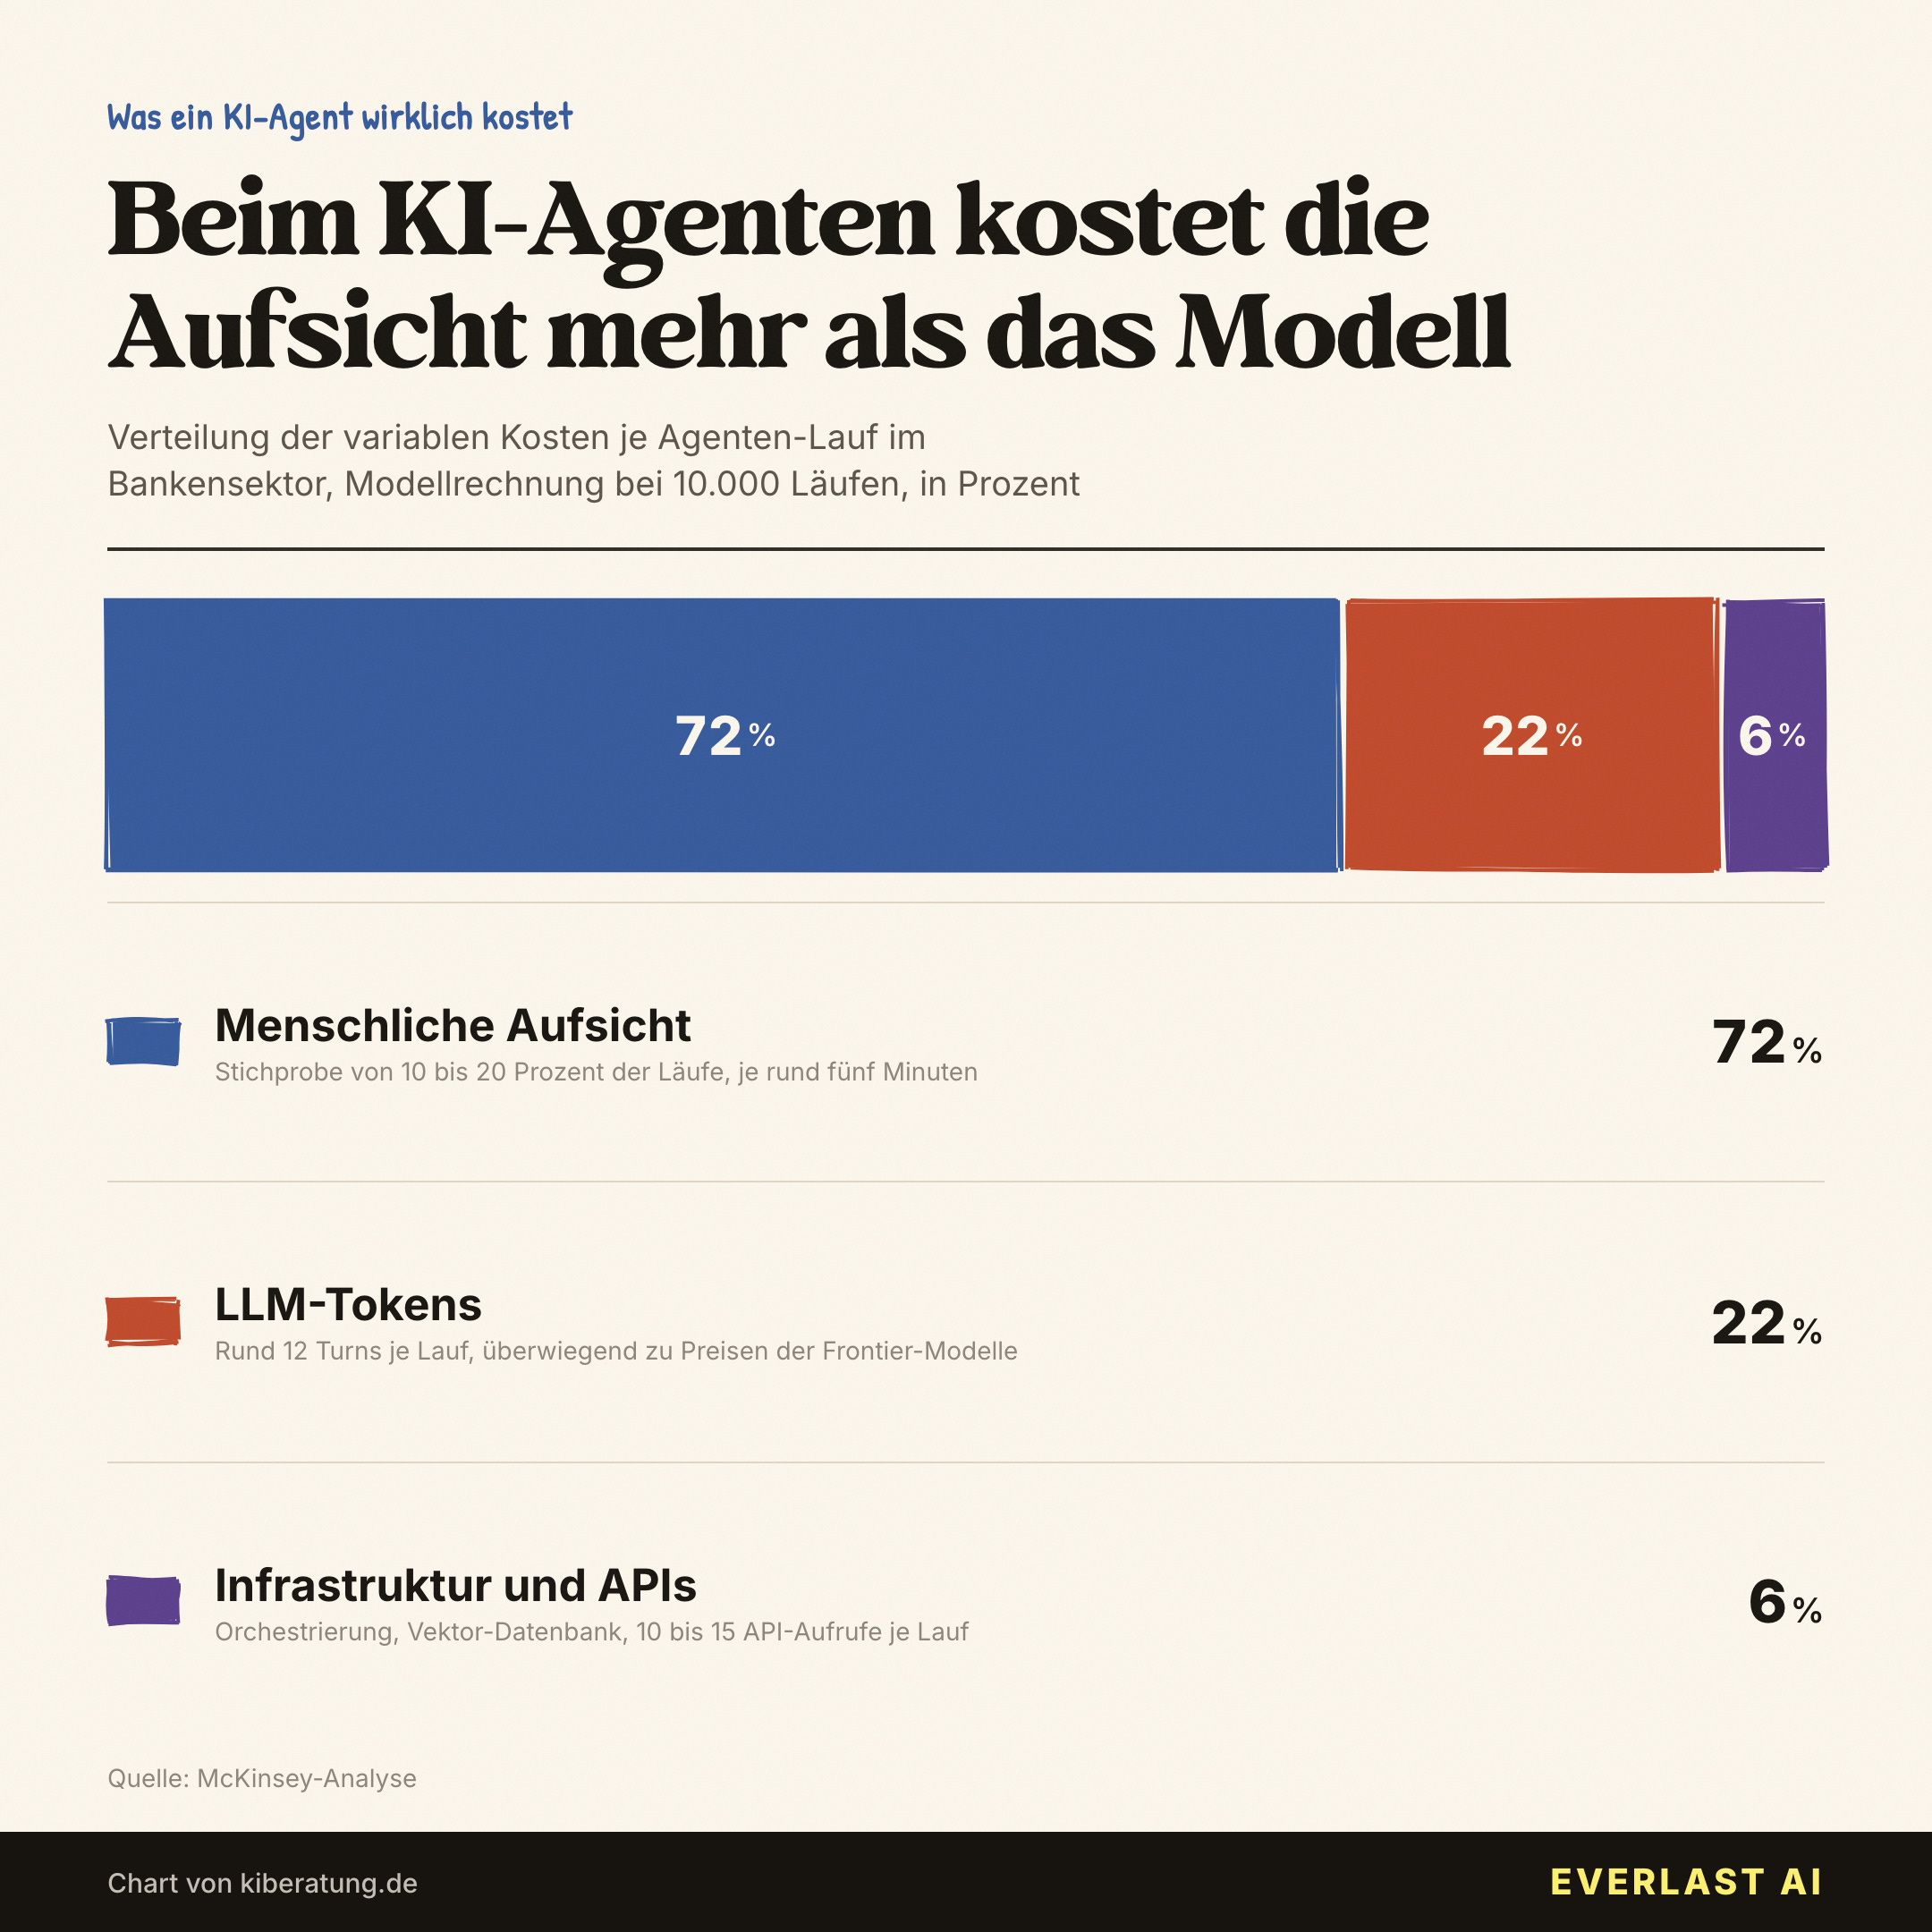
Chart des Tages: Aufsicht frisst 70 bis 75 Prozent der Agenten-Kosten
Quelle: McKinsey-Analyse
In einer McKinsey-Modellrechnung für den Bankensektor entfallen 70 bis 75 Prozent der variablen Kosten eines Agenten-Laufs auf die menschliche Kontrolle. Die Modell-Tokens selbst kommen auf 20 bis 25 Prozent, Infrastruktur und API-Aufrufe zusammen auf rund 6 Prozent. Gerechnet ist das auf 10.000 Läufe, bei denen 10 bis 20 Prozent der Ergebnisse von Mitarbeitern geprüft werden, je rund fünf Minuten. Wer nur die Token-Preise drückt, spart am kleineren Posten. Für die Wirtschaftlichkeit zählt eine andere Zahl: der Anteil der Läufe, den ein Mensch noch einmal anfassen muss.
Tool-Empfehlung: Voicely
Voicely ist eine DSGVO-konforme Diktiersoftware mit KI-gestützter Spracherkennung, die in jeder App läuft. Das Versprechen: fünfmal schneller schreiben, egal ob im Mailprogramm, im Dokument oder im Chatfenster. Ein nützlicher Werkzeugkasten-Eintrag für alle in der KI-Bubble, die nicht nur über Produktivität reden, sondern den eigenen Schreiballtag tatsächlich beschleunigen wollen, mehr Infos: voicely.de.